El Estudio GEO ChatGPT de ELNIQ GEO y Queseo revela por qué una única respuesta no basta para medir la visibilidad de una marca en la búsqueda con IA.
Estudio y datos, gratisInformes en cinco idiomas, datos originales y gráficos.
Ir a la descarga ↓Si preguntas a ChatGPT por los mejores profesionales de un sector, probablemente recibirás una lista con nombres, especialidades y argumentos que parecen bastante convincentes.
Pero ¿qué ocurre si repites exactamente la misma pregunta? ¿Vuelven a aparecer los mismos profesionales? ¿Se mantiene su posición? ¿Y qué pasa si utilizas la API de OpenAI en lugar de ChatGPT en el navegador?
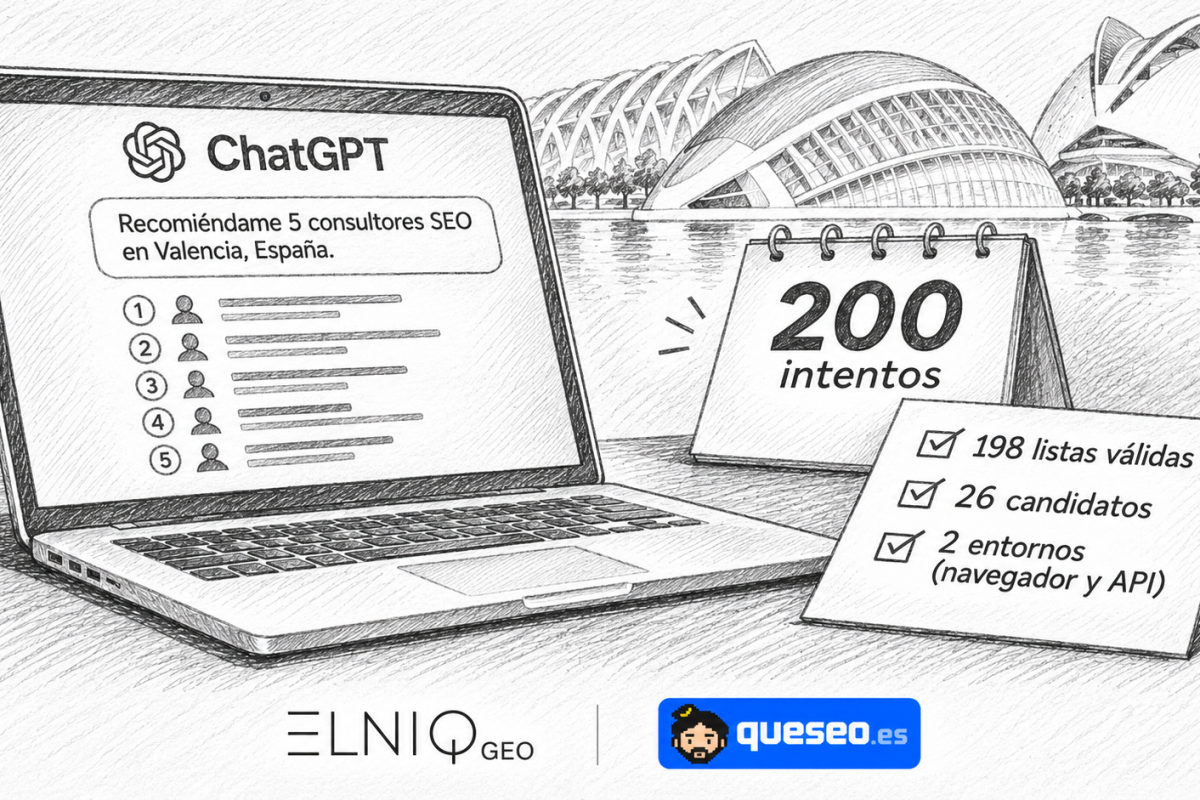
Para investigar estas cuestiones, desde ELNIQ GEO, junto con Eric Jorge Seguí Parejo, consultor SEO (Queseo), realizamos un experimento centrado en las recomendaciones de consultores SEO en Valencia.
Hicimos 200 intentos con la misma pregunta, en dos entornos diferentes. Obtuvimos 198 listas válidas y analizamos 990 puestos de recomendación.
El resultado principal es claro: las listas cambian constantemente, pero detrás de esa variación también aparecen patrones que podemos medir.
Y esto tiene consecuencias importantes para quienes intentan entender su visibilidad en ChatGPT.
| Hallazgo | Resultado observado |
|---|---|
| La lista ordenada casi nunca se repite | 94 listas diferentes en el navegador y 95 en la API. |
| Los entornos muestran opciones diferentes | Una lista de cada entorno comparte, de media, 1,77 de sus cinco nombres. |
| Aparecer y encabezar son medidas distintas | Queseo es la marca más frecuente en la API; Jesús Porres abre más listas. |
| Fuente no es recomendación | ip10.es figura en 96 de 97 registros de sitios, pero no ocupa ningún puesto de recomendación. |
| Pocas respuestas dan una visión parcial | Con 10 respuestas independientes, el margen orientativo es de ±31 puntos. |
El experimento: una pregunta, dos entornos
Utilizamos una consulta sencilla:
Recomiéndame 5 consultores SEO en Valencia, España. Explica brevemente por qué recomiendas a cada uno.
La repetimos 100 veces en ChatGPT gratuito, desde el navegador y sin iniciar sesión, y otras 100 veces mediante la API de OpenAI, utilizando el modelo gpt-5.6-luna con búsqueda web activada.
Las pruebas se realizaron entre el 8 y el 9 de noviembre de 2026. Eric se encargó de las consultas en el navegador, mientras que desde ELNIQ ejecutamos las pruebas mediante nuestra herramienta GEO Lab API Tester.
Dos intentos en el navegador no llegaron a completar una lista. Por tanto, el análisis se basa en 98 respuestas del navegador y 100 de la API.
| Condición | Navegador | API |
|---|---|---|
| Entorno | ChatGPT gratuito, sin iniciar sesión | API de OpenAI con búsqueda web |
| Modelo | Desconocido | gpt-5.6-luna |
| Intentos / listas válidas | 100 / 98 (los intentos 28 y 44 no se completaron) | 100 / 100 |
| Fechas | 8–9 de noviembre de 2026 | 8–9 de noviembre de 2026 |
Para contar los resultados, unificamos las distintas formas de referirse a una misma persona o marca. Por ejemplo, «Eric Jorge Seguí Parejo» y «Queseo» se contabilizaron como un único candidato.
No modificamos las webs de los participantes ni realizamos ninguna intervención destinada a mejorar su visibilidad. Nuestro objetivo era observar y medir el comportamiento de las recomendaciones.
Desconocemos qué modelo respondió en el navegador. Además, las condiciones de búsqueda y presentación eran distintas entre ambos entornos. Por eso, las diferencias observadas no pueden atribuirse exclusivamente al uso del navegador o de la API.
Vídeo-presentación del estudio
En este vídeo explicamos los principales resultados del experimento.
Este vídeo, todos los materiales del estudio y la descripción de nuestro trabajo y de los resultados obtenidos están disponibles también en el sitio del consultor SEO Queseo (Eric Jorge Seguí Parejo).
1. Casi cada respuesta ofrece una lista diferente
Este fue el primer resultado que nos llamó la atención.
De las 98 respuestas válidas del navegador, encontramos 94 listas diferentes al tener en cuenta tanto los nombres como su orden. En la API, obtuvimos 95 listas diferentes de 100.
Si ignoramos las posiciones y nos fijamos únicamente en qué cinco candidatos aparecen juntos, la variabilidad disminuye, pero sigue siendo considerable: 68 combinaciones distintas en el navegador y 67 en la API.
Para entender hasta qué punto se parecen las respuestas, comparamos las listas entre sí.
Dos respuestas del navegador compartían, de media, 2,30 nombres de cinco. En la API, la media fue de 2,62. Al comparar una lista del navegador con otra de la API, la coincidencia bajó a 1,77 nombres.
Gráfico 1Nombres compartidos por dos listas (de 5)
Media sobre 4.753 pares del navegador, 4.950 pares de la API y 9.800 pares cruzados.
En las 9.800 comparaciones posibles entre las listas del navegador y las de la API, hubo diez pares con los mismos cinco candidatos, aunque colocados en distinto orden. Ninguno coincidió exactamente en nombres y posiciones.
Esto significa que una respuesta aislada puede mostrar una parte muy limitada del conjunto de profesionales que ChatGPT llega a recomendar.
Si tu marca aparece en una consulta, no sabes todavía si es una presencia frecuente o una aparición excepcional. Y si no aparece, tampoco puedes concluir que ChatGPT nunca la recomienda.
Una respuesta es una observación, no una medición completa de la visibilidad.
2. La visibilidad cambia según el entorno
Otro resultado especialmente relevante fue la diferencia entre ChatGPT en el navegador y la API.
Algunos profesionales aparecían con mucha frecuencia en un entorno y apenas figuraban en el otro.
Por ejemplo, Enrique Tejedo fue recomendado en 77 de las 98 listas del navegador, pero solo en una de las 100 respuestas de la API. Queseo presentó el comportamiento contrario: apareció en 37 listas del navegador y en 87 de la API. Otros casos fueron menos extremos. Alex Figueiras apareció en 54 listas del navegador y en 62 de la API.
Gráfico 2Presencia en las listas, por entorno (%)
Porcentaje de listas válidas en las que aparece cada consultor (98 del navegador, 100 de la API). Se muestran seis de los 26 candidatos; el resto, en el informe.
No estamos diciendo que uno de los entornos recomiende mejor que el otro. Tampoco podemos afirmar que estos resultados se repetirían utilizando otro modelo, otro día o una configuración diferente.
Lo que sí demuestra nuestra muestra es que los resultados de una configuración de API no deben presentarse automáticamente como equivalentes a lo que ve un usuario de ChatGPT.
Esto afecta directamente a las herramientas que monitorizan la visibilidad en IA. Cuando una plataforma muestra un porcentaje de presencia o una posición media, es fundamental saber qué está midiendo: qué modelo utiliza, cómo realiza las consultas, si incorpora búsqueda web y en qué condiciones obtiene las respuestas.
Sin esa información, interpretar los resultados puede resultar engañoso.
3. Aparecer con frecuencia no significa ocupar las primeras posiciones
En SEO tradicional estamos acostumbrados a hablar de posiciones. En las recomendaciones de ChatGPT, sin embargo, la posición es solo una parte del problema.
Un profesional puede aparecer en muchas listas, pero casi siempre al final. Otro puede aparecer menos veces y, cuando lo hace, ocupar el primer puesto.
Alex Figueiras fue recomendado con una frecuencia relativamente parecida en los dos entornos: 54 veces en el navegador y 62 en la API. Sin embargo, encabezó 25 listas del navegador y solo dos de la API.
En las respuestas de la API, Queseo fue la marca con mayor presencia, con 87 apariciones. Pero Jesús Porres fue quien ocupó más veces el primer puesto: 50 frente a las 28 de Queseo.
| Consultor | Navegador: 1.º | Navegador: top 3 | API: 1.º | API: top 3 |
|---|---|---|---|---|
| Enrique Tejedo | 26 | 66 | 1 | 1 |
| Cerdá (Seomar) | 24 | 45 | 6 | 29 |
| Alex Figueiras | 25 | 39 | 2 | 27 |
| Jesús Porres | 10 | 31 | 50 | 74 |
| Queseo | 0 | 10 | 28 | 77 |
| Rocío Santamaría | 0 | 17 | 0 | 27 |
Número de listas en las que el consultor ocupa el primer puesto o está entre los tres primeros (navegador: 98 listas; API: 100).
Por tanto, para medir la visibilidad conviene separar al menos tres indicadores:
- Presencia: en qué porcentaje de respuestas aparece la marca.
- Posición: qué lugar ocupa cuando aparece.
- Enlace: si la respuesta incluye una dirección que permite visitar su web.
Ninguno de estos indicadores, por separado, permite valorar la calidad profesional de los candidatos. Y tampoco representan necesariamente tráfico o conversiones.
4. Aparecer en las fuentes no es lo mismo que ser recomendado
Una parte especialmente interesante de nuestro análisis fue la relación entre las fuentes registradas, los enlaces y los profesionales recomendados.
El ejemplo más ilustrativo fue IP10, un directorio que incluye una comparativa de consultores SEO en Valencia.
El dominio ip10.es figuraba en 96 de los 97 registros de sitios conservados del navegador. Su página comparativa aparecía en los 97 registros de páginas y la etiqueta de fuente «IP10» estaba presente en 68 de los 98 textos visibles. Sin embargo, IP10 no ocupó ninguno de los 990 puestos de recomendación analizados.
Este caso nos ayuda a distinguir cuatro situaciones diferentes: que una página figure en los registros asociados a una respuesta, que aparezca citada como fuente, que reciba un enlace directo y que una marca sea recomendada como proveedor. No son indicadores intercambiables.
Tampoco debemos asumir que la presencia de un dominio en un registro demuestra que su contenido fue leído antes de seleccionar a los candidatos. Los datos conservados no permiten reconstruir por completo ese proceso.
Para el análisis GEO, esta distinción es fundamental: la visibilidad de una fuente y la visibilidad de una marca como opción recomendada son fenómenos relacionados, pero diferentes.
5. ¿Cuántas respuestas necesitamos para medir la visibilidad?
Si una única respuesta no es suficiente, la siguiente pregunta es inevitable: ¿cuántas deberíamos recopilar?
En las 198 listas de nuestro experimento identificamos 26 candidatos diferentes. En el navegador, una selección de tres listas permitía encontrar una media de 9,4 candidatos distintos. Con diez listas, la cifra ascendía a 14,2. Con veinte, a 16,4.
Gráfico 3Candidatos distintos al revisar más listas
Número de listas revisadas →
Media de candidatos distintos en una selección aleatoria de k listas, calculada sobre las respuestas guardadas (26 candidatos en total). Navegador: 5,0 / 9,4 / 14,2 / 16,4 con 1 / 3 / 10 / 20 listas. API: 5,0 / 8,9 / 13,2 / 15,4. Describe la diversidad de nuestra muestra; no predice nombres futuros.
Estas cifras se calculan sobre las respuestas guardadas y describen la diversidad de nuestra muestra. No predicen cuántos nombres nuevos aparecerán en consultas futuras.
Hay otro problema: la incertidumbre estadística.
Como referencia teórica, si una marca aparece en aproximadamente el 50 % de las respuestas, una muestra de diez observaciones independientes tendría un margen orientativo de ±31 puntos porcentuales al 95 %. Con cien respuestas, ese margen se reduciría a aproximadamente ±9,8 puntos. Para acercarnos a ±5 puntos serían necesarias unas 385 observaciones, bajo los mismos supuestos estadísticos.
Gráfico 4Margen orientativo para una frecuencia real del 50 %
Intervalo al 95 % para una muestra de n respuestas independientes. Es un cálculo teórico, no una propiedad garantizada de ChatGPT.
Estos márgenes no están garantizados por ChatGPT. El cálculo presupone respuestas independientes y una frecuencia relativamente estable, condiciones que nuestro experimento no demuestra.
No existe, por tanto, un número universal de consultas que garantice una medición precisa. Lo que sí podemos afirmar es que las muestras pequeñas son muy sensibles a las variaciones y que cualquier porcentaje de presencia debería presentarse junto con el número de respuestas válidas utilizadas para calcularlo.
6. También importa lo que ChatGPT dice de una marca
Hasta ahora hemos hablado de nombres, posiciones y enlaces. Pero una recomendación tiene otro componente importante: la descripción que recibe el usuario.
Cuando alguien pregunta por un consultor SEO, ChatGPT no se limita a enumerar profesionales. Explica qué hace cada uno, cuáles son sus especialidades y para qué tipo de proyectos podría resultar adecuado.
En nuestro estudio observamos que algunas asociaciones se repetían. Queseo aparecía relacionado con las migraciones web en todas sus descripciones analizadas, tanto en el navegador como en la API. Jesús Porres se asociaba frecuentemente con negocios locales y servicios profesionales, mientras que Rocío Santamaría aparecía vinculada a la inteligencia artificial, GEO y la búsqueda generativa.
Esto nos lleva a una cuestión que las métricas de presencia no pueden resolver por sí solas:
¿ChatGPT está recomendando tu marca para los servicios y necesidades con los que realmente quieres posicionarte?
No es lo mismo aparecer como especialista en SEO local que como experto en migraciones técnicas o en comercio electrónico. Para una empresa, entender estas asociaciones puede ser tan relevante como contar cuántas veces aparece su nombre.
Pero hay una precaución importante: que ChatGPT atribuya una especialidad o cite una cifra de experiencia no significa que esa afirmación haya sido verificada de forma independiente.
7. Cuando la ficha, el enlace y la identidad no coinciden
El estudio también detectó discrepancias entre los nombres recomendados, los sitios enlazados y algunas fichas de negocio.
Por ejemplo, determinadas fichas asociadas a Jamil Mansilla incluían el dominio cristaleriasmansilla.com, mientras que el enlace de su descripción principal apuntaba a jamilmansilla.com. En otros casos, las fichas vinculadas a Rocío Santamaría mostraban un dominio y unas cifras de reseñas distintos de los que aparecían en el texto de la recomendación.
Estos ejemplos no demuestran por sí solos dónde se originaron los errores: podrían estar relacionados con la selección de las fichas, su presentación o la extracción de los datos. Pero revelan un riesgo que merece atención.
Una marca puede aparecer recomendada y, al mismo tiempo, estar acompañada de información que requiere comprobarse. Por eso, al analizar la visibilidad en IA también conviene revisar la consistencia de los nombres, dominios, fichas y datos atribuidos a cada entidad.
Además, en las respuestas del navegador encontramos fichas de negocio registradas en 40 de los 98 casos y mapas visibles en 32. La distribución de candidatos variaba entre respuestas con fichas y sin ellas, aunque nuestro experimento no permite establecer una relación causal.
Qué significa todo esto para la medición GEO
Nuestro experimento no ofrece una fórmula para conseguir que ChatGPT recomiende una marca. Tampoco pretende establecer quién es el mejor consultor SEO de Valencia.
Lo que ofrece es una base empírica para pensar cómo deberíamos medir la visibilidad en los sistemas de búsqueda generativa. A partir de los resultados, consideramos especialmente importantes tres principios.
- Medir repetidamente y documentar las condiciones. Una muestra necesita incluir la pregunta exacta, la fecha, el entorno, el modelo cuando se conozca y el número de respuestas válidas. Sin ese contexto, comparar porcentajes puede llevar a conclusiones equivocadas.
- Separar las diferentes dimensiones de la visibilidad. Presencia, posición, enlaces, fuentes, mapas y descripciones aportan información distinta. No deberían reducirse automáticamente a una única puntuación.
- Observar los cambios a lo largo del tiempo. Nuestro experimento se realizó durante una única noche y con una sola pregunta sobre un sector concreto. Para entender si los patrones se mantienen, necesitamos repetir las pruebas en otras fechas y condiciones comparables.
Esta es una de las líneas de investigación que queremos seguir desarrollando desde GEO Lab: herramientas y metodologías que ayuden a observar la búsqueda con IA de forma reproducible, transparente y basada en datos.
Un estudio conjunto de ELNIQ GEO y Queseo


Declaración de interés: Queseo es también una de las marcas recomendadas en las respuestas analizadas. Se aplica el mismo criterio de recuento a todos los candidatos.
El análisis se basa en los datos obtenidos los días 8 y 9 de noviembre de 2026. El informe completo incluye las tablas de los 26 candidatos, las comparaciones entre respuestas, los registros de enlaces, los análisis de fuentes y los detalles metodológicos.
Estudio y datos abiertos
Descarga la investigación
Informe completo, metodología y datos originales de la investigación. Acceso libre.
¿Qué hay en el archivo?
- Estudio_GEO_ChatGPT_ELNIQ_Queseo (ES, EN, VA, RU, UK).pdf El estudio final en PDF, de 31 páginas, en cinco idiomas: español, inglés, valenciano, ruso y ucraniano.
- datos-en-bruto-de-consultas.zip Los dos Excel originales con las respuestas: uno del navegador y otro de la API.
- Estudio_Claude_GEO_ELNIQ_Queseo.zip Análisis previo hecho con Claude sobre los mismos datos: 3 PDF, 3 Excel y 6 gráficas en PNG.
- Estudio_GEO_ChatGPT_Valencia.zip Análisis previo hecho con ChatGPT sobre los mismos datos: un PDF y 12 gráficos y tablas en PNG.
Sigue la investigación en GEO Lab
Herramientas y metodologías para observar la búsqueda con IA de forma reproducible, transparente y basada en datos.
Referencias
- Aggarwal et al. (2024). GEO: Generative Engine Optimization. arxiv.org/abs/2311.09735v3
- Liu, Zhang & Liang (2023). aclanthology.org/2023.findings-emnlp.467
- OpenAI. Web search, fuentes. developers.openai.com
- NIST/SEMATECH e-Handbook of Statistical Methods. itl.nist.gov
Investigación: ELNIQ GEO × Queseo
Autores: Nina S. Dzhezher y Eric Jorge Seguí Parejo
Recogida de datos: 8–9 de noviembre de 2026 · Informe: 11 de noviembre de 2026
Más información: ELNIQ GEO · Queseo
Estudio y datos, gratisInformes en cinco idiomas, datos originales y gráficos.
Ir a la descarga ↓